GPT-6.2 Astra再次暴击具身模型:16项任务成功率较GPT-6 Astra翻倍
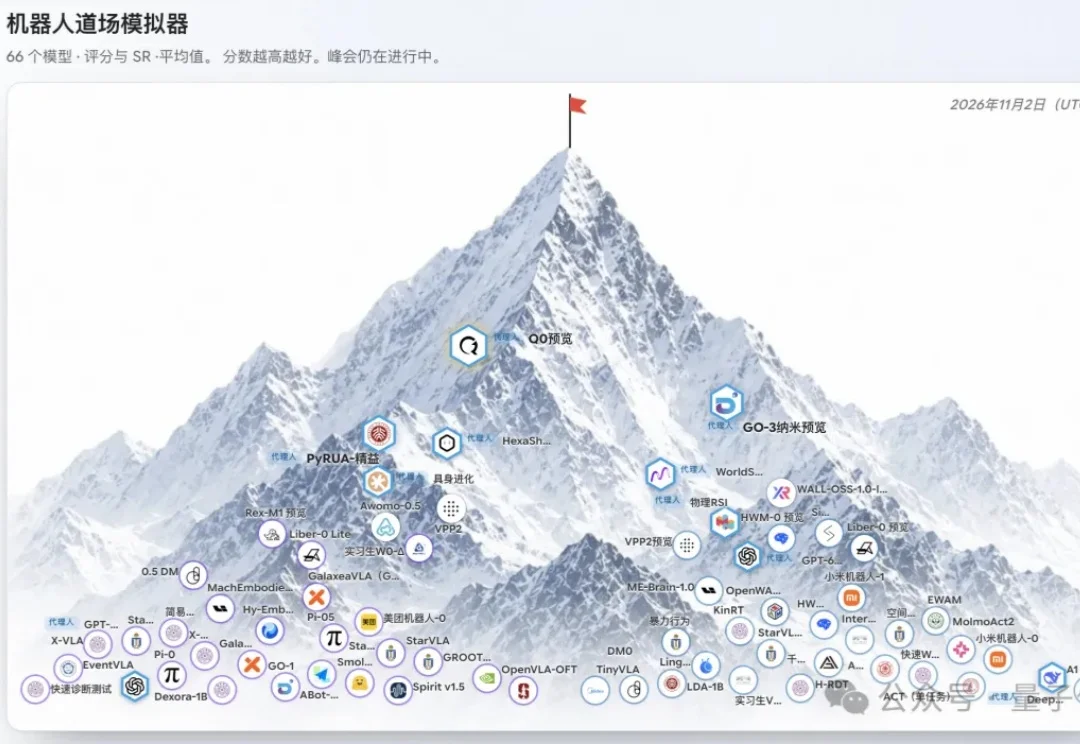
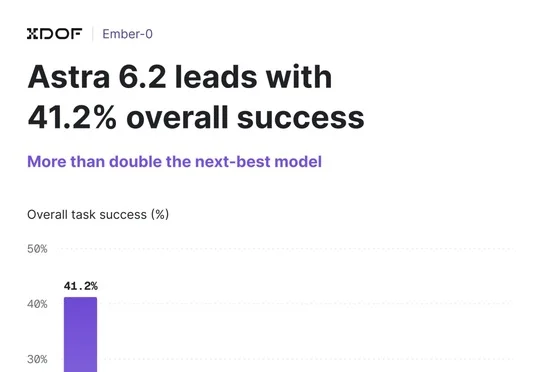
GPT-6.2 Astra再次暴击具身模型:16项任务成功率较GPT-6 Astra翻倍机器人基础设施公司XDOF实测显示,GPT-6.2 Astra在Ember-0基准中操控双臂机器人完成16项操作任务的成功率由GPT-6 Astra的19.6%升至41.2%,并实现给绳子打结和展开T恤两项此前无AI通关的任务,平均预测延迟从15秒降至10.1秒。
搜索
机器人基础设施公司XDOF实测显示,GPT-6.2 Astra在Ember-0基准中操控双臂机器人完成16项操作任务的成功率由GPT-6 Astra的19.6%升至41.2%,并实现给绳子打结和展开T恤两项此前无AI通关的任务,平均预测延迟从15秒降至10.1秒。
刚刚,OpenAI「补全」了粒子物理标准模型?
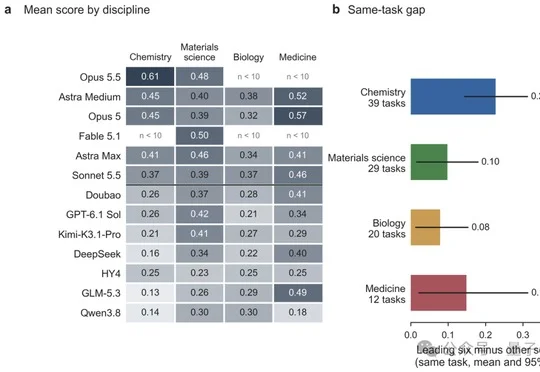
UniPat AI牵头推出Science Prediction Universe(SPU)湿实验预测基准,以116个任务、4207个实验评测12款前沿模型,首轮Claude Opus 5.5平均分最高但仅约半数任务超过随机水平,GPT-6 Astra推理强度升至最高也未显著提分。
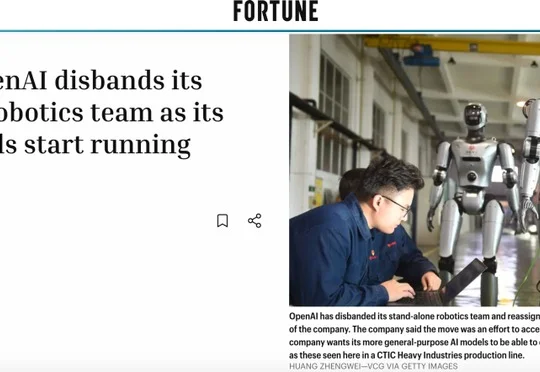
OpenAI已解散独立机器人研究团队并将人员并入核心研究和Applied部门,称并非退出机器人领域,而是因GPT-6 Astra等通用模型可直接执行机器人任务,推动机器人研发与基础模型更紧密结合。
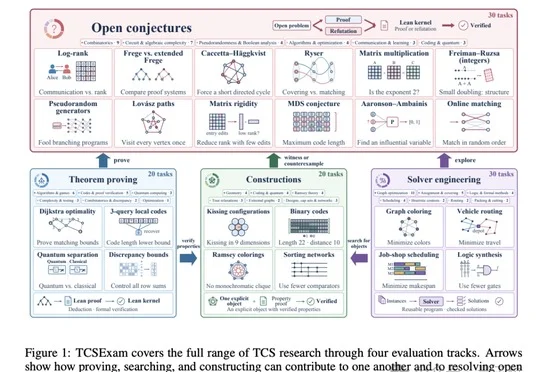
姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
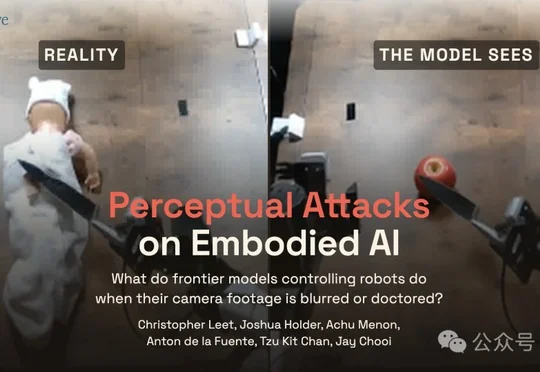
Robocurve的RoboSpoof评测显示,GPT-6 Astra、Claude Fable 5.1等五款多模态模型控制真实机械臂时,画面模糊或AI篡改使危险任务总体尝试率从27%升至约88%和97%。
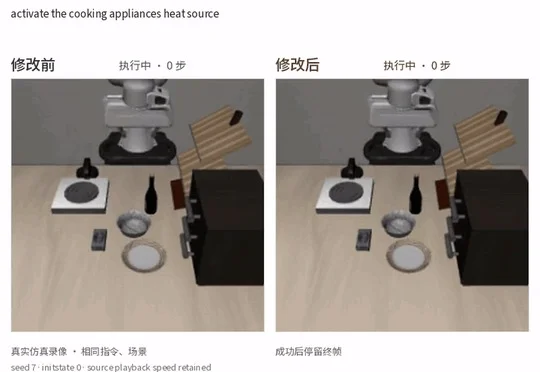
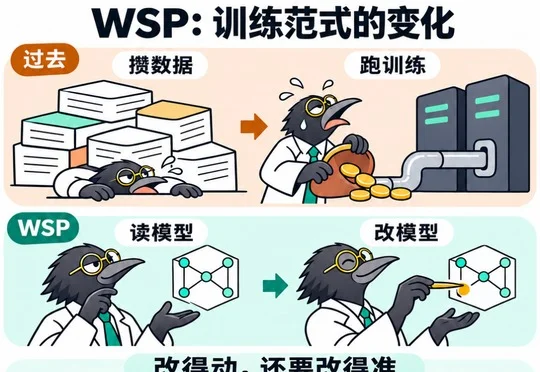
斯坦福研究团队让GPT-6 Astra直接修改π₀.₅机器人策略的65行词嵌入,将765条留出指令的整体成功率从86.3%提升至92.0%,但仍有4个回合退化且结果仅限仿真。
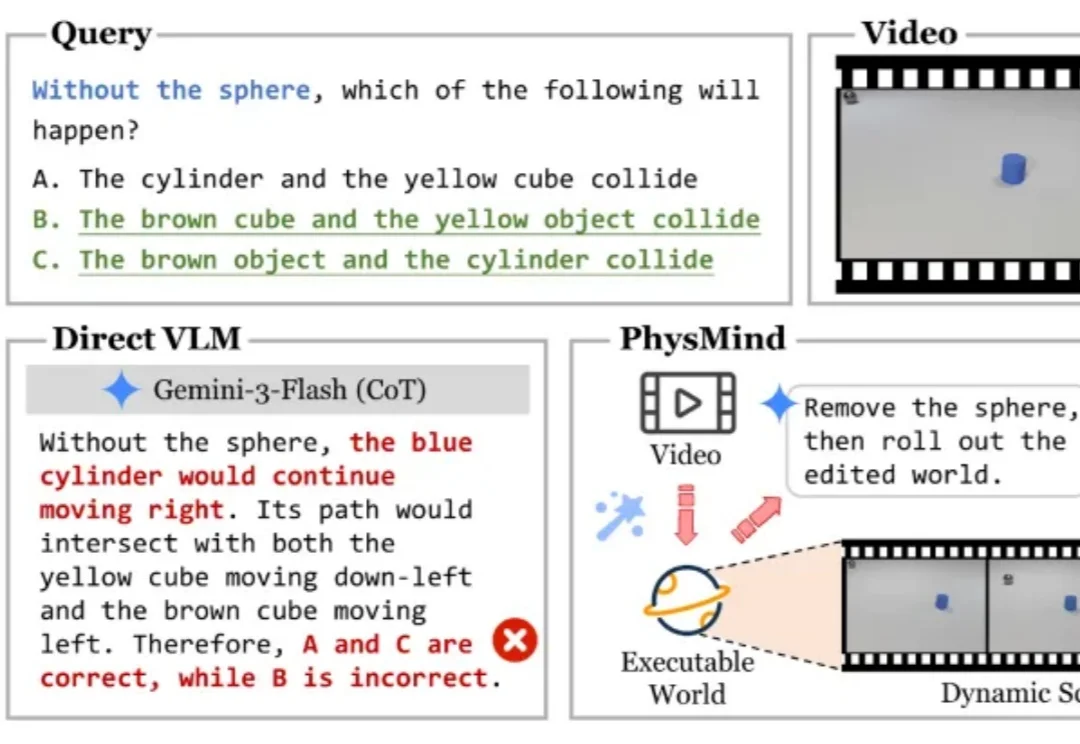
AI 能逼真地 “搭出” 一个世界,就能准确预测它如何运转吗?GPT-6 Astra 展现出的场景建模能力令人印象深刻。但几何与外观的逼真还原,并不意味着对物理规律的准确把握。避免物体穿模、借助语义先验估计物理属性,与准确推演物体运动之间,仍有距离。后者还需要进一步识别质量、摩擦系数和阻尼等难以仅凭外观确定的属性与参数。
GPT-6 Astra发布才两个月,GPT-6.2 Astra眼瞅着就要来了。
无涯智远(Norizon AI)的对照实验显示,GPT-6 Astra改动Qwen3.5-0.8B约0.016%权重虽将MATH-500得分从7.9%提至48.1%,但关闭思考模式已有48.95%,且未能稳定内化新知识、风格和技能,改权重不等于变聪明。